БЯМ-ли насоветовали установить: - Orc[hestrator]: Ориентирован на «управление задачами». Вы определяете дерево задач,
агент регистрируется, занимает задачу, выполняет её, сдаёт. Он
принудительно блокирует переход задачи к следующему шагу до выполнения
зависимостей, подходит для проектов с чётким разделением труда. - shared-context-server:
Предоставляет общее пространство сессий, несколько MCP-клиентов (Claude
Code, Cursor и др.) могут читать и записывать одно и то же состояние
через HTTP, подходит для сценариев, где нужно «видеть промежуточные
результаты друг друга». Это чтобы сохранять промежуточные результаты и прочее полезное из контекстов. - cabildo: Предоставляет инструменты типа claim (занять ресурс), release, send (отправить сообщение), inbox. Когда движок A собирается изменить файл, он сначала вызывает claim("src/main.rs"); если B тоже попытается занять этот файл, он получит отказ. В нём также есть очередь git push, которая предотвращает взаимное перезаписывание коммитов двух агентов.
Поддержка проекта
Помогите нам развивать платформу и создавать новый контент для разработчиков игр.
ПоддержатьДирижирование БЯМ-ми
Так может в БЯМ и написать такой? под свои задачи.
https://github.com/FoundationAgents/MetaGPT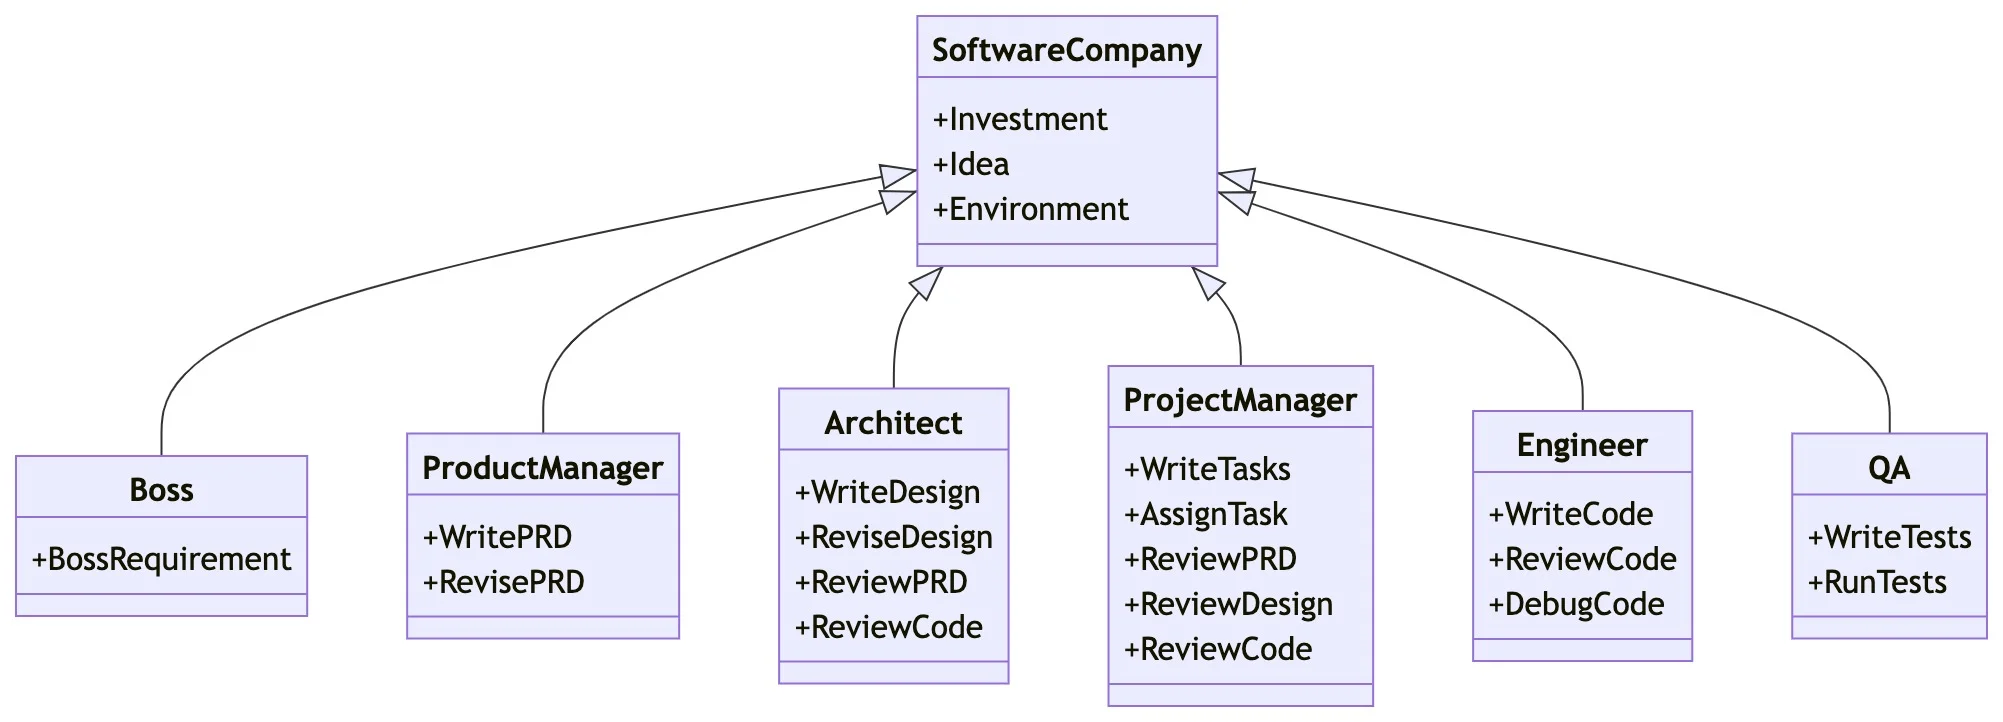
https://github.com/crewaiinc/crewai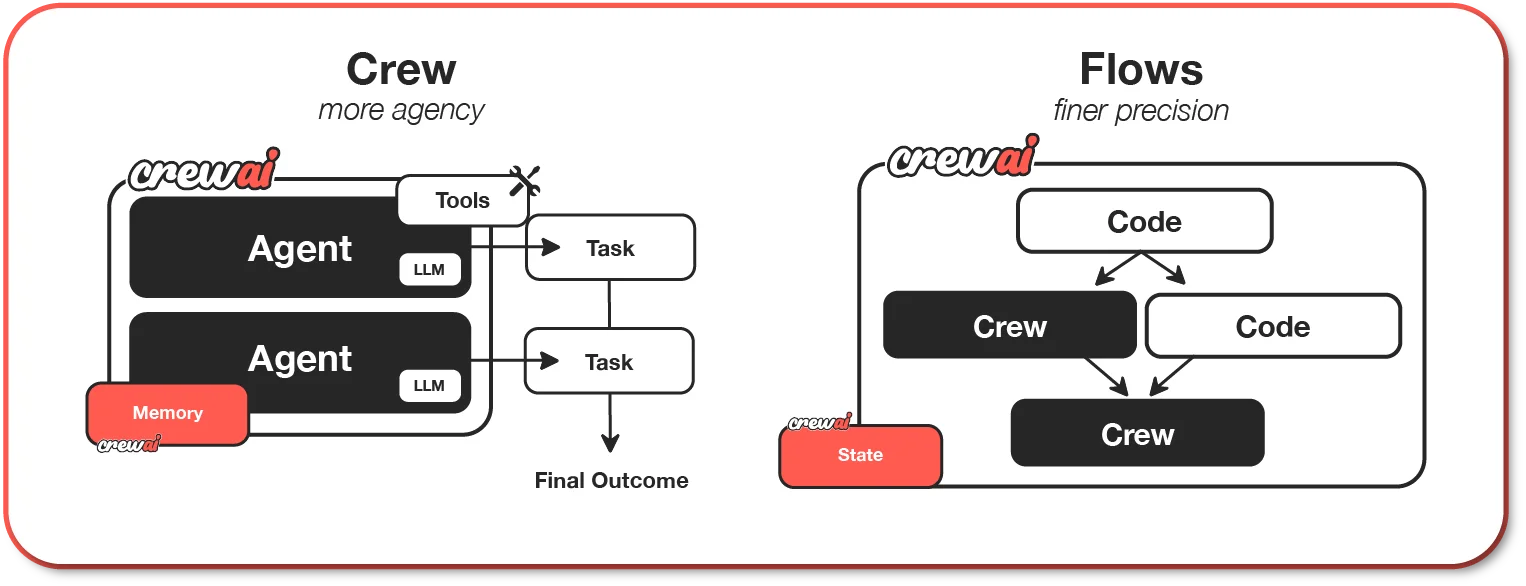
Сэм Альтман, руководитель компании OpenAI: [1]
Локальный инференс — это крайне неэффективное распределение дефицитных ресурсов. Многие хотят использовать локальный инференс, полагая, что раз появились модели с открытым исходным кодом, которые можно запускать на собственных компьютерах, то необходимость в мощностях дата‑центров отпадает. Однако, если смотреть на ситуацию в глобальном масштабе, это крайне нерационально: значительная часть мирового запаса оперативной памяти (DRAM) стоит на пользовательских компьютерах, где она используется лишь пять процентов времени. В условиях жесткого дефицита ресурсов необходимо стремиться к максимальной загрузке мощностей в облаке.
https://habr.com/ru/news/1101840/
В принципе ведь правильно говорит (для нас, для нищебродов). Но и секретные (конфиденциальные) данные надо держать в секрете. Разделив роли разных БЯМ-лей можно добиться переноса большей части нагрузки в датацентры, и при этом ключевую информацию сохранять в секрете.
Хотите присоединиться к обсуждению?
Войти в аккаунт